Was ist LLM-Integration und wann lohnt sie sich?
LLM-Integration verbindet ein großes Sprachmodell mit Ihren Daten und Prozessen. Der Nutzen entsteht nicht durch das Modell allein, sondern durch die saubere Anbindung an bestehende Systeme. Ein Modell, das Tickets liest, im CRM nachschlägt und einen Antwortentwurf zur Freigabe legt, spart messbar Zeit – ein Chatfenster ohne Systemkontext nicht.
Sinnvoll wird die Integration, sobald unstrukturierte Inhalte (Texte, Dokumente, E-Mails) verstanden, zusammengefasst oder klassifiziert werden sollen. Wir ordnen Ihren Anwendungsfall ein und grenzen ihn klar gegen die übergeordnete KI-Strategie und Integration im Unternehmen ab: Dort liegt der Schwerpunkt auf Roadmap und Governance, hier auf der konkreten technischen Anbindung.
Typische Einstiegsfälle sind interne Wissensassistenten, Dokumentenextraktion, E-Mail-Triage und Antwortvorschläge im Service. Für autonome, mehrstufige Abläufe verbinden wir die LLM-Integration mit KI-Agenten für mehrstufige Workflows.
Projekt-Referenzen
Ausgewählte Case Studies aus unserer Projektpraxis
Dokumentierte Beispiele mit transparentem Falltyp – passende Referenzen durchblättern oder die Case Study öffnen.
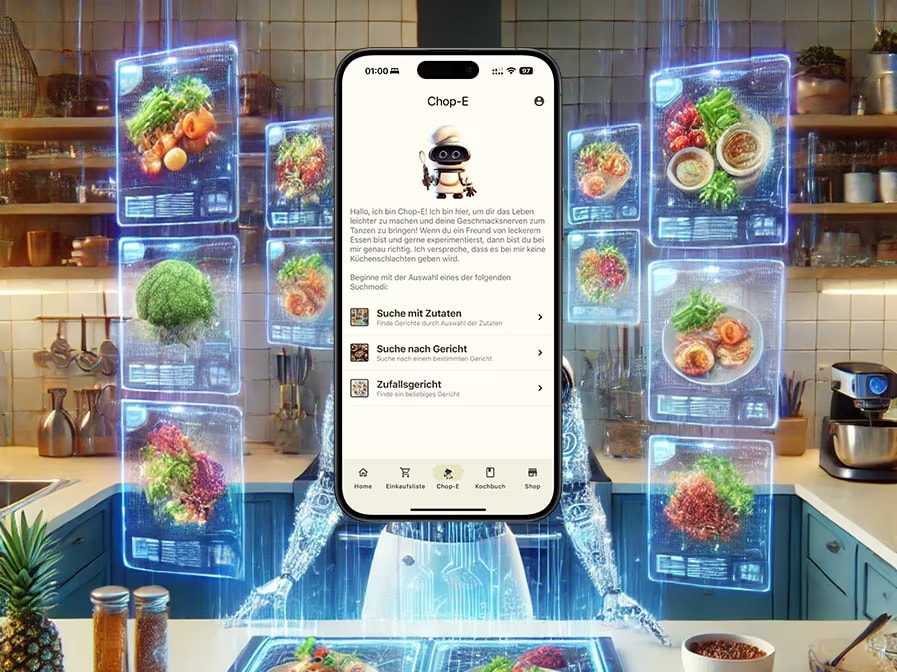
Beispiel: Antwortentwürfe direkt im Ticketsystem
Ein typischer Integrationsfall beginnt mit einem vorhandenen Ticketsystem. Dessen API übergibt Betreff, Nachricht und freigegebene Metadaten an einen Integrationsdienst. RAG sucht dazu passende Abschnitte in freigegebenen Handbüchern. Das LLM erstellt einen Entwurf mit Quellenhinweisen; Mitarbeitende prüfen und versenden ihn. Das Beispiel beschreibt einen möglichen Aufbau, keine veröffentlichte Kundenreferenz.
Erfolgskriterien sind vorab definierte Testfälle, Quellenabdeckung, Antwortzeit, Freigabequote und Kosten je bearbeitetem Ticket. Die technische Verbindung zum Ticketsystem entsteht über robuste API- und Schnittstellenentwicklung.
Modellauswahl nach Qualität, Latenz, Datenverarbeitung und Kosten
Wir arbeiten modell-agnostisch und entscheiden nach Anforderung statt nach Hersteller-Präferenz. Die folgende Übersicht ordnet typische Modellklassen nach Stärke, Hosting und Eignung ein:
| Modellklasse | Stärke | Hosting | Eignung |
|---|---|---|---|
| Gehostetes General-Purpose-Modell | Breites Sprachverständnis, multimodal | Anbieter-API, Region und Bedingungen prüfen | Allrounder, schneller Start |
| Long-Context-Modell | Lange Kontexte, präzise Anweisungsfolge | Anbieter-API oder verwaltete Plattform | Dokumentenanalyse, Verträge |
| Open-Weight-Modell | Open-Weight, volle Datenkontrolle | On-Premise / EU-Cloud | Kontrollierter Eigenbetrieb bei passender Infrastruktur |
| Spezialisierte Modelle | Fine-getunt für Domäne/Aufgabe | Je nach Basis | Fachvokabular, festes Format |
Für strukturierte Vorhersagen statt Textgenerierung kombinieren wir Sprachmodelle mit klassischem Machine Learning aus der ML-Entwicklung. Wer Microsoft 365 nutzt, fährt für den Arbeitsalltag oft am schnellsten mit Microsoft Copilot im Office-Umfeld.
RAG, Fine-Tuning und Embeddings: die richtige Architektur
Retrieval Augmented Generation (RAG) ist meist der schnellste und günstigste Weg zu belastbaren Antworten: Das Modell greift zur Laufzeit auf Ihre Dokumente in einer Vektordatenbank zu. Antworten bleiben aktuell, nachvollziehbar und an Quellen gebunden. Die fachliche Tiefe dazu liefert unsere KI-Wissensdatenbank mit RAG. Für dialogorientierte Oberflächen setzen wir dieselbe Architektur in LLM-Chatbot entwickeln lassen um – mit Eskalation an Mitarbeitende und CRM-Anbindung.
Prompting steuert Aufgabe, Ausgabeformat und Grenzen ohne Modelltraining. Fine-Tuning verändert dagegen das Modellverhalten anhand kuratierter Trainingsbeispiele und lohnt sich erst bei ausreichend wiederholbaren Mustern. RAG stellt aktuelles, freigegebenes Wissen zur Laufzeit bereit. Diese drei Bausteine werden separat evaluiert und nur bei nachgewiesenem Nutzen kombiniert. Die Anbindung an ERP, CRM oder DMS realisieren wir über stabile Schnittstellen und API-Integration.
DSGVO, Hosting und Datenhoheit
Datenschutz ist bei jeder LLM-Integration ein eigener Prüf- und Umsetzungsstrang. EU-Hosting kann Datenwege verkürzen; On-Premise kann externe Modellaufrufe vermeiden. Beides garantiert für sich allein keine DSGVO-Konformität. Zweck, Rechtsgrundlage, Datenklassen, Auftragsverarbeitung, Speicherfristen, Löschung, Zugriffe und mögliche Drittlandtransfers müssen zum konkreten Verfahren passen.
Wir dokumentieren technische Datenflüsse und setzen vereinbarte Pseudonymisierung, Filter, Rollen und Protokollierung um. Erforderliche Verträge und Rechtsgrundlagen werden mit den zuständigen Datenschutz- und Rechtsverantwortlichen geprüft. Exit-Strategie und Modell-Austauschbarkeit planen wir von Anfang an ein. Die regulatorische Einordnung begleiten wir über die EU AI Act Beratung.
Guardrails, Evaluation und produktiver Betrieb
Eine LLM-Integration ist erst dann produktionsreif, wenn Qualitätskriterien und Betriebsabläufe definiert sind. System-Prompts und Guardrails reduzieren unerwünschte Ausgaben, können sie aber nicht ausschließen. Evaluation mit Testfällen und Variantenvergleichen zeigt Unterschiede; Monitoring und Logging machen Qualitätsabfälle, Latenz und Kosten untersuchbar.
Für kritische Entscheidungen bleibt eine menschliche Freigabe verbindlich. Modelle, Preise und Schnittstellen können sich ändern; deshalb versionieren wir Prompts und Konfiguration, überwachen Qualität, Latenz und Kosten und führen Regressionstests vor Änderungen aus. Wer Routineprozesse rund um die LLM-Integration automatisieren will, kombiniert sie mit unserer KI-Automatisierung für Geschäftsprozesse.
Vorgehen: von der Analyse bis zum Betrieb
- Use-Case & Datenlage: Wir klären Ziel, Datenquellen, Schutzbedarf und Erfolgskriterien.
- Architektur & Modellwahl: RAG vs. Fine-Tuning, Hosting (Azure EU oder On-Premise), Modellklasse – an Ihren Daten validiert.
- Pilot: Funktionsfähige Integration mit Guardrails und Evaluation am wichtigsten Anwendungsfall; Umfang und Dauer ergeben sich aus Systemen, Daten und Testfällen.
- Produktivbetrieb: Anbindung an ERP/CRM, Monitoring, Logging, Schulung und kontinuierliche Optimierung.
Häufig gestellte Fragen
LLM-Integration: Modelle, RAG, Datenschutz und Kosten
Modelle, Architektur und Betrieb
Was bedeutet LLM-Integration für ein Unternehmen?
LLM-Integration bezeichnet die technische Anbindung eines geeigneten gehosteten oder selbst betriebenen Sprachmodells an ERP, CRM, DMS oder Ticketsysteme.
Statt ein Chatfenster isoliert zu nutzen, fließen Modellantworten in echte Workflows: Dokumente werden analysiert, Anfragen klassifiziert, Entwürfe erstellt und zur Freigabe vorgelegt. Entscheidend ist die passende Integrationstiefe – von API und Prompting über RAG bis zum optionalen Fine-Tuning.
Welches LLM ist das richtige für unseren Anwendungsfall?
Wir arbeiten modell-agnostisch und prüfen verfügbare Modelle zum Entscheidungszeitpunkt an repräsentativen Testfällen.
Maßgeblich sind Qualität in Ihrer Domäne, Latenz, Kontext- und Ausgabegrenzen, Datenverarbeitung, Betriebsoptionen und Kosten pro Vorgang. Ein Open-Weight-Modell kann eigenen Betrieb ermöglichen, verhindert aber nicht automatisch weitere Datenflüsse in Suche, Logging oder Monitoring.
Wie bleibt eine LLM-Integration DSGVO-konform?
Weder ein EU-Rechenzentrum noch On-Premise-Betrieb garantiert DSGVO-Konformität.
Entscheidend sind Zweck und Rechtsgrundlage, Datenminimierung, Auftragsverarbeitung, Speicher- und Löschkonzept, Zugriffsrechte sowie mögliche Drittlandtransfers. Wir dokumentieren den technischen Datenfluss und setzen die vereinbarten Kontrollen um; die rechtliche Bewertung bleibt eine gesonderte Prüfung.
RAG oder Fine-Tuning – was ist sinnvoller?
In den meisten Fällen ist Retrieval Augmented Generation (RAG) der schnellere und günstigere Weg: Das Modell greift zur Laufzeit auf Ihre Dokumente zu, Antworten bleiben aktuell und belegbar.
Fine-Tuning lohnt sich, wenn ein fester Stil, ein Fachvokabular oder ein wiederkehrendes Aufgabenmuster erlernt werden soll. Oft kombinieren wir beides – RAG für Wissen, Fine-Tuning für Format und Tonalität.
Was kostet eine LLM-Integration?
Der KI-Agent-Integrationsrechner weist 7.140 – 210.203 € zzgl.
MwSt. als unverbindliche Projektspanne aus. Für ein Ticketszenario kalkulieren wir beispielsweise monatliche Tickets × durchschnittliche Eingabe- und Ausgabetokens × aktuelle Anbieterpreise und ergänzen erwartete Wiederholungen. Suche, Vektordatenbank, Monitoring und Infrastruktur kommen je nach Architektur hinzu.
On-Premise-Betrieb ersetzt API-Kosten durch Rechenleistung, Administration und Wartung.
Wie vermeiden wir Halluzinationen und sichern Qualität?
Durch RAG mit belegten Quellen, klare System-Prompts, Guardrails und Evaluation: Wir messen Antwortqualität mit Testfällen, A/B-Vergleichen von Prompts und Modellen sowie menschlichem Feedback.
Monitoring und Logging zeigen Qualitätsabfälle, Latenz und Kosten sofort. Für kritische Entscheidungen bleibt eine menschliche Freigabe (Human-in-the-Loop) verbindlich.
LLM-Integration besprechen
Wir klären Anwendungsfall, Modellwahl und nächste Schritte – unverbindlich.
Verwandte Leistungen und Informationen
- Künstliche Intelligenz: Strategie & Integration im Unternehmen
- LLM-Chatbot entwickeln lassen (AI Chatbot)
- KI-Wissensdatenbank (RAG) für Unternehmenswissen
- KI-Agenten für autonome Workflows
- Microsoft Copilot im Microsoft-365-Arbeitsalltag
- Machine-Learning-Entwicklung für Vorhersagemodelle
- KI- und LLM-Kosten im Überblick