Machine-Learning-Entwicklung verbindet Domänenwissen, saubere Daten und belastbare Modelle. Statt vager KI-Versprechen priorisieren wir Prognose- und Klassifikationsprobleme, die sich mit versionierten Datensätzen, fachlichen Baselines, geeigneten Metriken und Abnahmetests belegen lassen.
Machine Learning Lösungen für Unternehmen im Mittelstand scheitern selten an Algorithmen, sondern an fehlendem Labeling, instabilen Schnittstellen und fehlendem Betrieb nach dem Go-Live. Deshalb planen wir Pipeline, Modell-Evaluation und Monitoring früh, damit kein isolierter Proof of Concept in der Schublade landet.
Unser Fokus bleibt Entwicklung Made in Germany mit klaren Meilensteinen, reproduzierbaren Experimenten und Integration in Ihre Bestands-IT. Vertiefen Sie dazu unseren Leistungsrahmen Künstliche Intelligenz im Geschäftseinsatz, rechnen Sie Kosten und Szenarien im Kostenrechner Künstliche Intelligenz durch, und prüfen Sie, wie Datenanalyse die Grundlage für belastbare ML-Modelle liefert. Programme für den Mittelstand starten oft über KI-Lösungen für den Mittelstand; skalierbare Multi-Use-Case-Roadmaps über KI-Lösungen für Unternehmen.
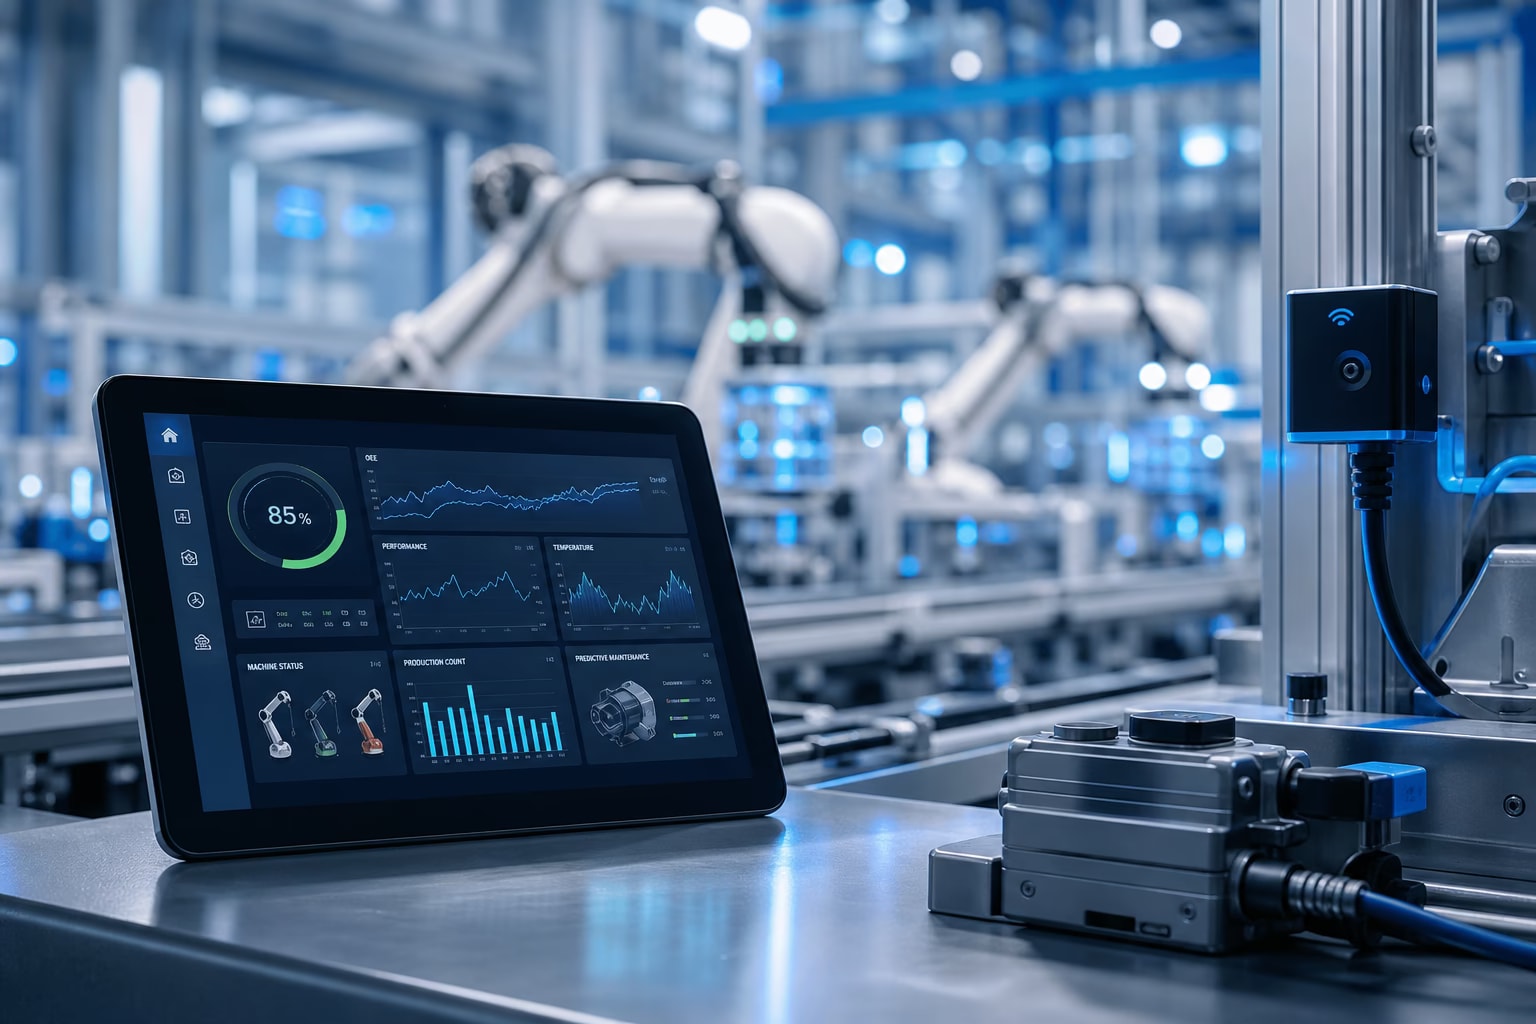
ML-Modelle im Produktionsbetrieb benötigen mehr Engineering als das Training — Datenpipelines, Monitoring und Drift-Erkennung entscheiden über Zuverlässigkeit.
Für Auftraggeber bedeutet das: Ein Modell, das im Labor funktioniert, aber ohne Retraining-Rhythmus und Datenqualitäts-Monitoring deployed wird, verliert leise an Genauigkeit — oft unbemerkt, bis Fehlentscheidungen in Prozessen sichtbar werden.
Typischer nächster Schritt ist ein strukturiertes Gespräch zu Kennzahl, Trainingsdaten, Integrationspunkten und Verantwortlichkeiten in Fachbereich und IT. So vermeiden Sie teure Sackgassen, in denen Modelle zwar im Labor glänzen, im ERP aber nicht zuverlässig landen.
Wir dokumentieren Datenflüsse, Modellversionen und Service-Level so, dass Nachvollziehbarkeit für Revision, Partner und Management gewährleistet bleibt. Ziel bleibt immer derselbe messbare Output: stabilere Prozesse, weniger manuelle Routine und Entscheidungen, die sich vor CFO und Betriebsrat rechtfertigen lassen.
Projekt-Referenzen
Ausgewählte Case Studies aus unserer Projektpraxis
Dokumentierte Beispiele mit transparentem Falltyp – passende Referenzen durchblättern oder die Case Study öffnen.
Machine Learning Lösungen für Unternehmen: Grundlagen, Nutzen und Lernverfahren
Was Machine Learning in der Praxis leistet
Machine Learning (ML) ermöglicht Systemen, aus Daten zu lernen und Vorhersagen oder Klassifikationen zu treffen, ohne jede Regel manuell zu programmieren. So können Sie beispielsweise Ausfälle vorhersagen, Texte kategorisieren, Anomalien erkennen oder personalisierte Empfehlungen aussprechen. Wir entwickeln ML-Modelle, die in Ihre Prozesse und IT-Landschaft integriert werden und messbaren Nutzen stiften.
Supervised und Unsupervised Learning
Beim Supervised Learning (überwachtes Lernen) trainieren wir das Modell mit gelabelten Daten: jeder Eingabe ist ein bekanntes Ergebnis zugeordnet. Typische Aufgaben: Klassifikation (z. B. E-Mail Spam ja/nein, Kunde kündigt ja/nein) und Regression (z. B. Absatzprognose, Preisvorhersage). Das Modell lernt Muster aus den Beispieldaten und generalisiert auf neue Fälle. Beim Unsupervised Learning (unüberwachtes Lernen) gibt es keine vorgegebenen Labels; das System findet Strukturen in den Daten, etwa Clustering (Kundensegmentierung, Anomalie-Erkennung), Dimensionsreduktion oder Empfehlungssysteme auf Basis von Ähnlichkeiten.
Reinforcement Learning und Methodenwahl
Beim Reinforcement Learning lernt ein Agent durch Belohnung und Bestrafung optimale Aktionen in einer Umgebung – z. B. Steuerung von Robotern, Spielstrategien oder dynamische Preis- und Lagerpolitik. Für die meisten Unternehmensanwendungen (Prognosen, Klassifikation, Dokumentenverarbeitung) setzen wir überwachtes Lernen ein; unüberwachtes Lernen nutzen wir beispielsweise für Segmentierung und Anomalie-Erkennung. So bringen wir die richtige Methode gezielt für Ihr Problem zum Einsatz.
KI Modelle entwickeln lassen: Anwendungsfälle und Beispiele aus der Praxis
Sensordaten von Maschinen (Vibration, Temperatur, Durchsatz) werden kontinuierlich erfasst und mit ML-Modellen ausgewertet. Das System lernt das „normale“ Verhalten und erkennt Abweichungen, die auf bevorstehende Ausfälle hindeuten. So können Wartungen geplant werden, bevor es zu Stillständen kommt – mit messbar weniger ungeplanten Ausfällen und längeren Laufzeiten. Typische Techniken: Anomalie-Erkennung, Zeitreihen-Prognosen oder Survival-Modelle. Wir integrieren die Modelle in Ihre bestehende IoT- oder Produktions-IT und sorgen für reproduzierbares Training und Monitoring.
Welche Kunden drohen abzuwandern? Anhand von Transaktionsdaten, Klickverhalten, Bestellabständen und ggf. demografischen Merkmalen trainieren wir Klassifikationsmodelle, die die Wahrscheinlichkeit einer Kündigung oder Inaktivität vorhersagen. So kann das Marketing gezielt Retention-Maßnahmen (Rabatte, personalisierte Angebote) steuern. Typische Metriken: Precision/Recall für die gewünschte Segmentgröße, AUC-ROC. Das Modell wird als API oder Batch-Job in Ihre CRM- oder Marketing-Pipeline integriert und regelmäßig mit neuen Daten nachtrainiert.
ML-Modelle können bei der Auswertung von Röntgen-, CT- oder pathologischen Bildern unterstützen – z. B. zur Erkennung von Auffälligkeiten, zur Segmentierung von Gewebe oder zur Priorisierung von Fällen. Wichtig: Der Einsatz unterliegt regulatorischen Anforderungen (z. B. MDR/IVDR bei Medizinprodukten). Wir entwickeln Modelle, die als Entscheidungsunterstützung dienen können, und achten auf Dokumentation, Validierung und – wo nötig – Zulassungswege. Technologisch setzen wir auf CNNs, Transfer Learning und geeignete Trainings- und Test-Splits.
Zeitreihen-Modelle prognostizieren den zukünftigen Absatz oder Bedarf pro Artikel, Standort oder Kanal. So lassen sich Bestellmengen und Lagerbestände optimieren – weniger Überbestände und weniger Fehlmengen. Wir nutzen klassische Verfahren (ARIMA, Prophet) oder moderne Ansätze (LSTM, Transformer), je nach Datenmenge und Anforderung. Saisonality, Trends und externe Faktoren (Feiertage, Wetter) werden einbezogen. Die Prognosen werden in Ihre Warenwirtschaft oder ERP integriert und laufend mit neuen Verkaufsdaten aktualisiert.
KI erkennt Dokumenttypen, extrahiert Felder (Beträge, Daten, Lieferadressen) und ordnet Belege automatisch zu (Buchungskreis, Kostenstelle, Lieferant). So sinkt der manuelle Aufwand in Buchhaltung und Einkauf deutlich; Fehler werden reduziert und Durchlaufzeiten verkürzt. Wir setzen OCR, NLP und ggf. spezielle Dokumenten-Modelle ein und trainieren auf Ihren Daten, damit Layout und Formulare Ihrer Lieferanten zuverlässig erkannt werden. Die Lösung wird in Ihre ERP- oder DMS-Prozesse integriert, inklusive menschlicher Freigabe für Grenzfälle.
Unser ML-Entwicklungsprozess
In 6 Phasen bringen wir Ihr ML-Projekt von den Daten bis in den produktiven Betrieb. Die Kernelemente lassen sich in vier zentrale Schritte fassen: Datenerfassung, Modelltraining, Evaluation und Deployment.
Datenerfassung
In der Phase der Datenerfassung identifizieren wir alle relevanten Datenquellen (Datenbanken, APIs, Dateien, Sensoren) und prüfen Qualität, Vollständigkeit und Eignung für die geplante ML-Aufgabe. Wir bereinigen fehlerhafte oder doppelte Einträge, vereinheitlichen Formate und schaffen ein reproduzierbares Pipeline für fortlaufende Datenerfassung. Wo nötig, ergänzen wir Labels (manuell oder halbautomatisch) für überwachtes Lernen. Am Ende steht ein konsolidierter, dokumentierter Datensatz sowie eine klare Aufteilung in Trainings-, Validierungs- und Testdaten – die Grundlage für ein belastbares Modell.
Modelltraining
Beim Modelltraining wählen wir passende Algorithmen (z. B. Random Forest, Gradient Boosting, neuronale Netze) und trainieren sie auf den vorbereiteten Daten. Feature Engineering und Hyperparameter-Tuning optimieren die Leistung; wir protokollieren alle Experimente mit MLflow (Open-Source-Tool für Experiment-Tracking), damit Ergebnisse nachvollziehbar und reproduzierbar sind. Das Training läuft in einer kontrollierten Umgebung (lokal oder Cloud); bei Bedarf nutzen wir GPU-Ressourcen für tiefe Netze. Am Ende steht ein trainiertes Modell, das wir in der nächsten Phase unabhängig bewerten.
Evaluation
In der Evaluation prüfen wir das Modell auf Hold-out-Daten, die während des Trainings nicht genutzt wurden. Je nach Aufgabe setzen wir Metriken wie Accuracy, Precision, Recall, F1-Score, AUC-ROC oder maßgeschneiderte KPIs ein. Wir analysieren Fehlerfälle – bei Bedarf mit SHAP (Verfahren zur Erklärung von Modellentscheidungen) – und prüfen, ob das Modell fair und stabil über verschiedene Segmente (z. B. Zeiträume, Kundengruppen) funktioniert. Erst wenn die Qualität die vereinbarten Schwellen erfüllt und keine kritischen Bias-Probleme vorliegen, gehen wir in die Produktion.
Deployment
Beim Deployment bringen wir das Modell in den produktiven Einsatz – typischerweise als API, Batch-Job oder Integration in Ihre Anwendungen. Wir packen Modell und Abhängigkeiten in Container (z. B. Docker), konfigurieren Skalierung und Monitoring und stellen sicher, dass Vorhersagen schnell und zuverlässig ausgeliefert werden. Nach dem Go-Live überwachen wir Performance und Datenqualität; bei Drift Detection (automatisch erkannte Datenverteilungsverschiebung) oder Verschlechterung planen wir Retraining oder Anpassungen. So bleibt Ihr ML-System langfristig nutzbar und messbar.
Reproduzierbarer Technologie-Stack für Training und Betrieb
Wir setzen auf Python mit TensorFlow und PyTorch für tiefe Netze, scikit-learn für klassisches ML, MLflow für Experiment-Tracking und Deployment, Hugging Face Transformers für NLP und LangChain für KI-Workflows. Reproduzierbare Experimente, versionierte Modellartefakte, Container-Deployments und Monitoring machen die Lösung übergabefähig. Ergänzend: Künstliche Intelligenz Leistungsüberblick, KI-Chatbot-Entwicklung für Dialogsysteme und KI-Wissensdatenbank für Unternehmenswissen.
Machine Learning vs. Regelbasierte Systeme
| Kriterium | ML | Regelbasiert |
|---|---|---|
| Flexibilität | Passt sich an neue Muster an | Feste Regeln, manuelle Anpassung |
| Genauigkeit bei komplexen Daten | Hoch bei ausreichend Daten | Hoch, wenn Regeln eindeutig sind |
| Erklärbarkeit | Teilweise eingeschränkt (z. B. bei Deep Learning) | Vollständig nachvollziehbar |
| Datenabhängigkeit | Braucht Trainingsdaten | Regeln aus Domänenwissen |
| Wartungsaufwand | Retraining bei Drift | Regeln pflegen bei Änderungen |
Machine Learning produktiv einsetzen: vom Piloten zum Betriebssystem
Ein Machine-Learning-Modell ist erst dann wertvoll, wenn es täglich Entscheidungen verbessert – nicht wenn es im Demo läuft. Der Weg von der Proof-of-Concept-Phase zur produktiven Nutzung erfordert mehr als Modelltraining: robuste Datenpipelines, Monitoring, Fehlerbehandlung und klare Verantwortlichkeiten für den laufenden Betrieb.
Wir entwickeln ML-Systeme von Anfang an mit dem Ziel produktiver Nutzung: Datenpipelines, die täglich aktualisierte Daten liefern, APIs, die sich in Ihre bestehenden Systeme einfügen, und Monitoring-Dashboards, die zeigen, ob das Modell noch korrekt arbeitet.
- ✓ Automatische Datenqualitätsprüfung vor jedem Training
- ✓ Versionierte Modelle mit Rollback-Möglichkeit
- ✓ Performance-Monitoring mit konfigurierbaren Alarmschwellen
- ✓ Retraining-Pipeline bei Daten-Drift
- ✓ Dokumentierte REST-API oder Batch-Integration
- ✓ SLA-fähiger Betrieb auf AWS, Azure oder On-Premise
Unser Leistungsangebot umfasst die vollständige ML-Infrastruktur: von der Datenstrategie über Modellentwicklung bis zum Produktivbetrieb. Sprechen Sie uns an, wenn Sie konkrete Anwendungsfälle in Ihrem Unternehmen identifiziert haben.