Python — die führende Sprache für Daten und KI
Python ist die Sprache mit dem größten Ökosystem für Datenverarbeitung, Machine Learning und KI-Entwicklung. Mit Frameworks wie Django und FastAPI entstehen skalierbare Web-APIs und Backend-Systeme – von einfachen REST-APIs bis zu komplexen Datenverarbeitungs-Plattformen mit Celery, Redis und PostgreSQL.
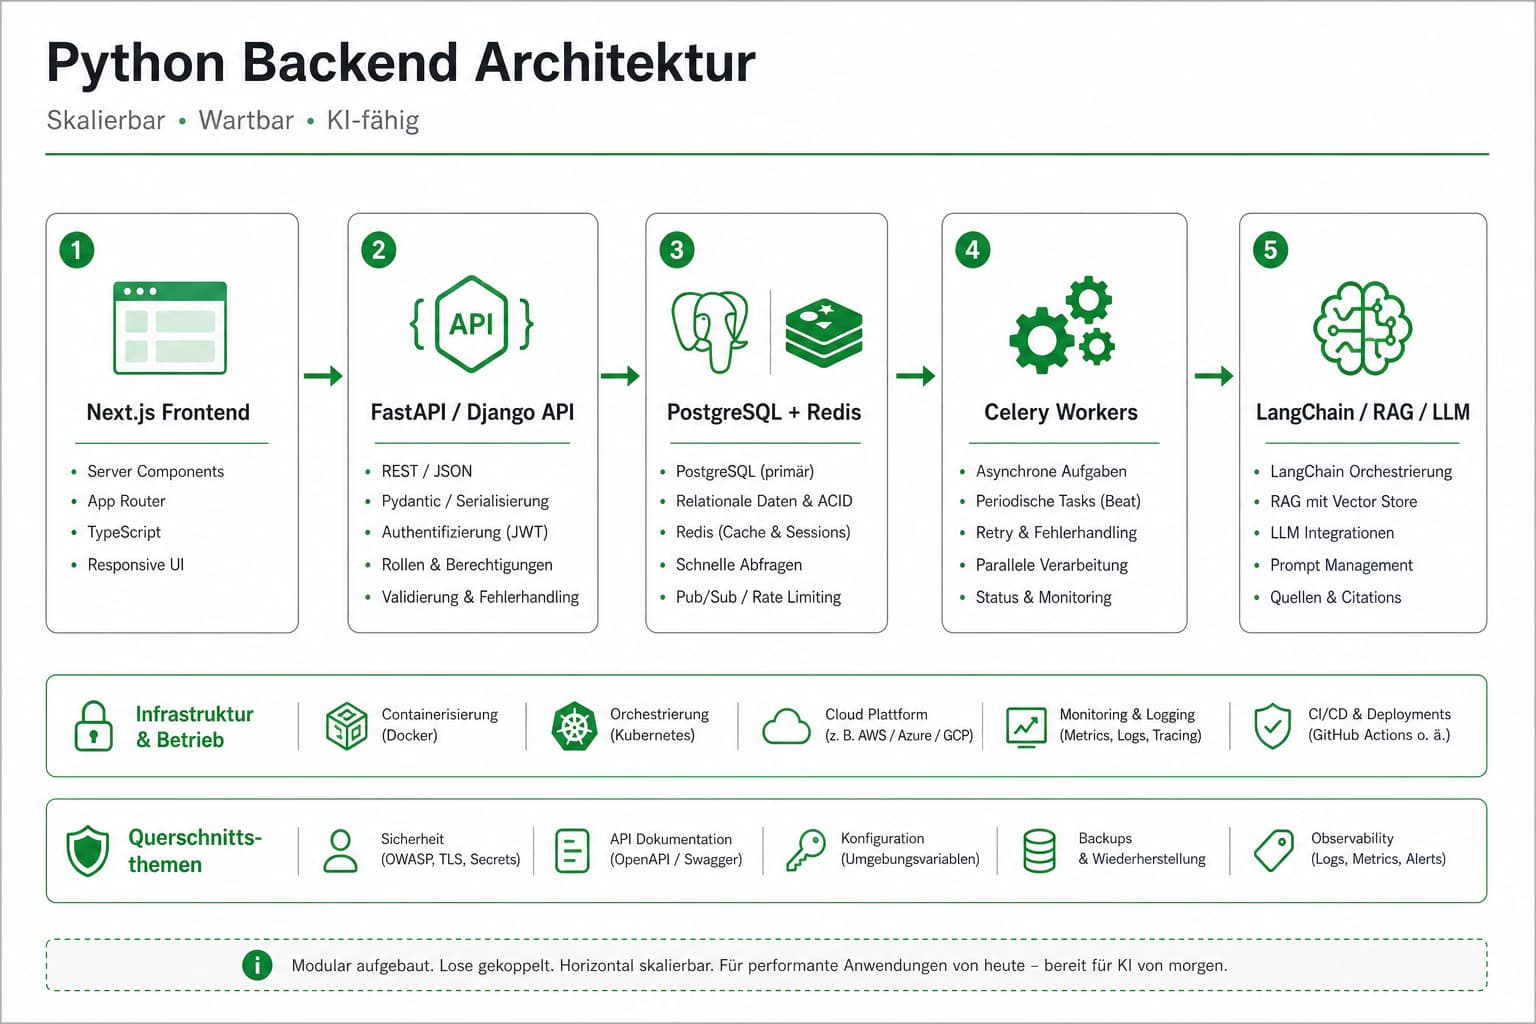
Für viele KI-Anwendungen ist Python wegen des Ökosystems rund um PyTorch, scikit-learn und Hugging Face eine naheliegende Wahl. Wir entwickeln damit Backends, REST-APIs, ETL-Pipelines und KI-Integrationen – von der Architektur bis zur dokumentierten Betriebsübergabe auf der vereinbarten Infrastruktur.
Python-Entwicklung ergänzt unsere Arbeit in Individualsoftware und KI-Lösungen. Technologie-Überblick: Python – Stack-Details auf unserer Technologie-Seite.
Projekt-Referenzen
Ausgewählte Case Studies aus unserer Projektpraxis
Dokumentierte Beispiele mit transparentem Falltyp – passende Referenzen durchblättern oder die Case Study öffnen.



Unsere Python-Leistungen
Django-Anwendungen
Django ist das "batteries included"-Framework für komplette Web-Anwendungen: Django ORM für Datenbankmodelle, Django Admin als eingebautes Backend-Interface, Django REST Framework (DRF) für APIs und Django Channels für Echtzeit-Funktionen. Wir entwickeln Django-Anwendungen mit sauberem App-Design, Custom User-Modellen, Celery für Hintergrundaufgaben und vollständigem Test-Setup (pytest-django). Deployment via Docker auf AWS ECS, Kubernetes oder klassischen VPS-Setups.
FastAPI-Backends und Microservices
FastAPI eignet sich für typisierte APIs mit async/await, automatischer OpenAPI-Dokumentation und Pydantic-Validierung. Wir entwickeln FastAPI-Backends für KI-APIs (ML-Inference, LLM-Integrationen), Microservices und Performance-kritische Komponenten – containerisiert auf Kubernetes mit DevOps-Pipeline.
ETL-Pipelines und Datenverarbeitung
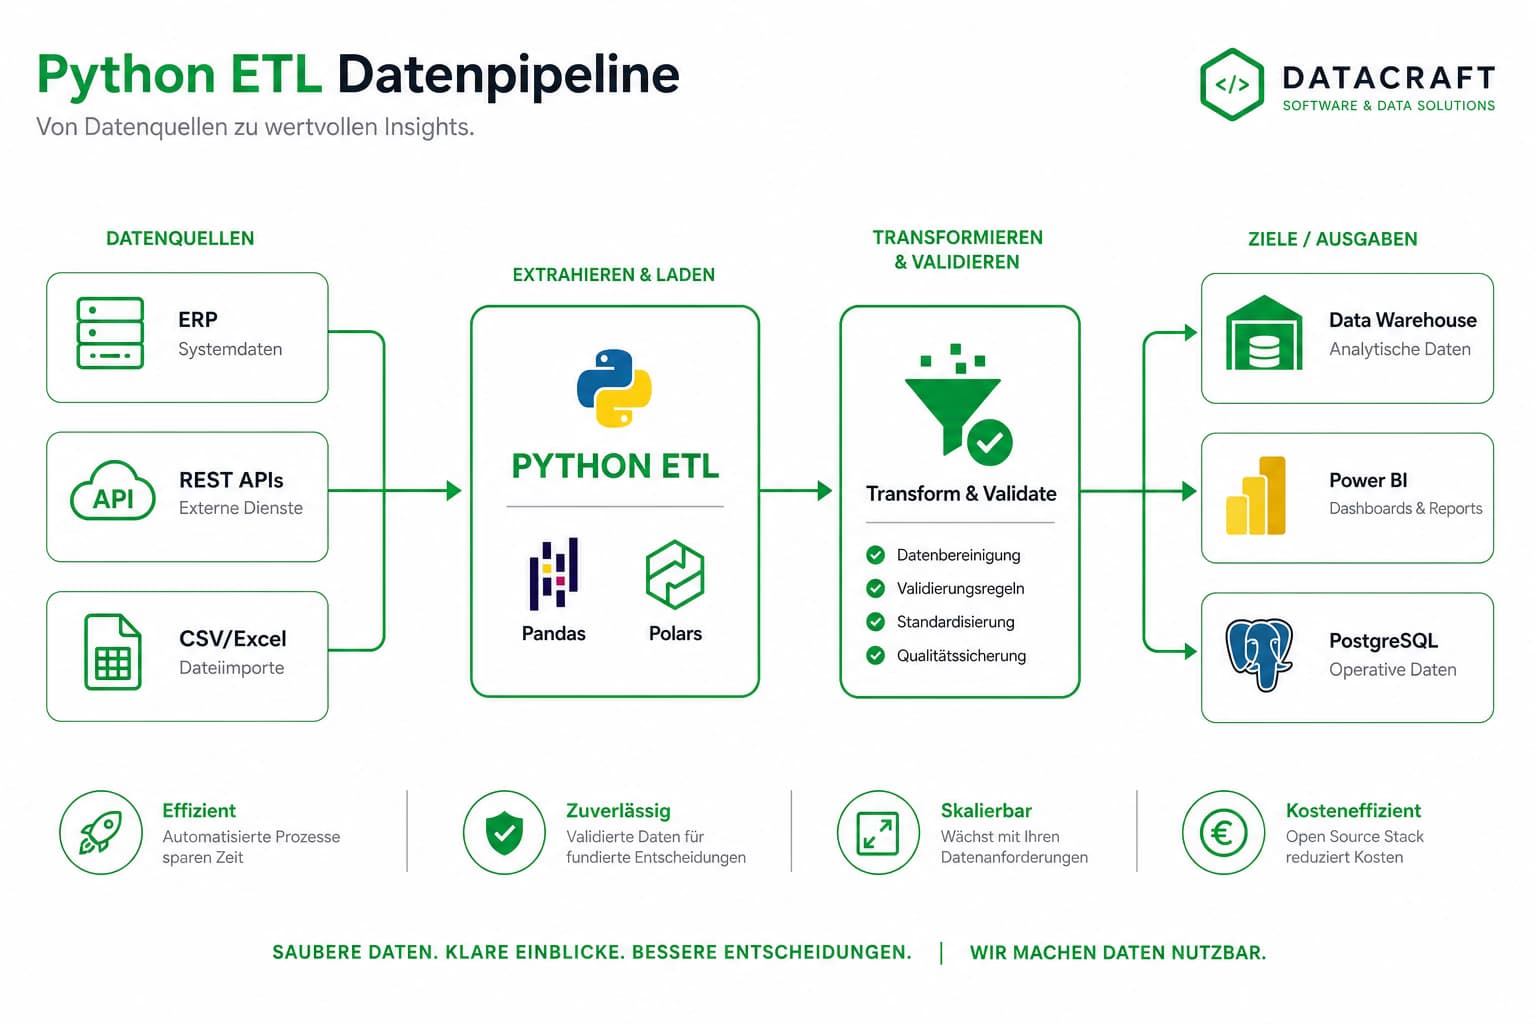
Python ist die Standard-Sprache für ETL-Prozesse (Extract, Transform, Load): Daten aus APIs, Datenbanken, CSV/Excel oder ERP-Systemen extrahieren, transformieren und in Data Warehouses laden. Wir nutzen Pandas, Polars, SQLAlchemy und Airflow – ergänzend zu Business Intelligence und Automatisierung.
KI- und ML-Integration
Python ist die erste Wahl für KI-Backends: LangChain und LlamaIndex für RAG-Systeme, OpenAI- und Anthropic-API-Integration, FastAPI als Inference-API und Vektordatenbanken (pgvector, Chroma) für semantische Suche. Mehr: KI-Agenten und KI-Chatbots.
Django & FastAPI
Skalierbare Web-Anwendungen und High-Performance-APIs – mit Django ORM, DRF und async FastAPI.
ETL & Datenverarbeitung
Pandas, Polars, Airflow und SQLAlchemy – robuste ETL-Pipelines für Datenintegration und BI.
KI & ML-Backends
LangChain, FastAPI-Inference-APIs und RAG-Systeme – KI-Integration für Produktionsumgebungen.
Deployment & DevOps
Docker, Kubernetes, AWS ECS und CI/CD – Python-Anwendungen produktionsreif deployed.
Python in der Praxis: vom Prototyp zum produktiven System
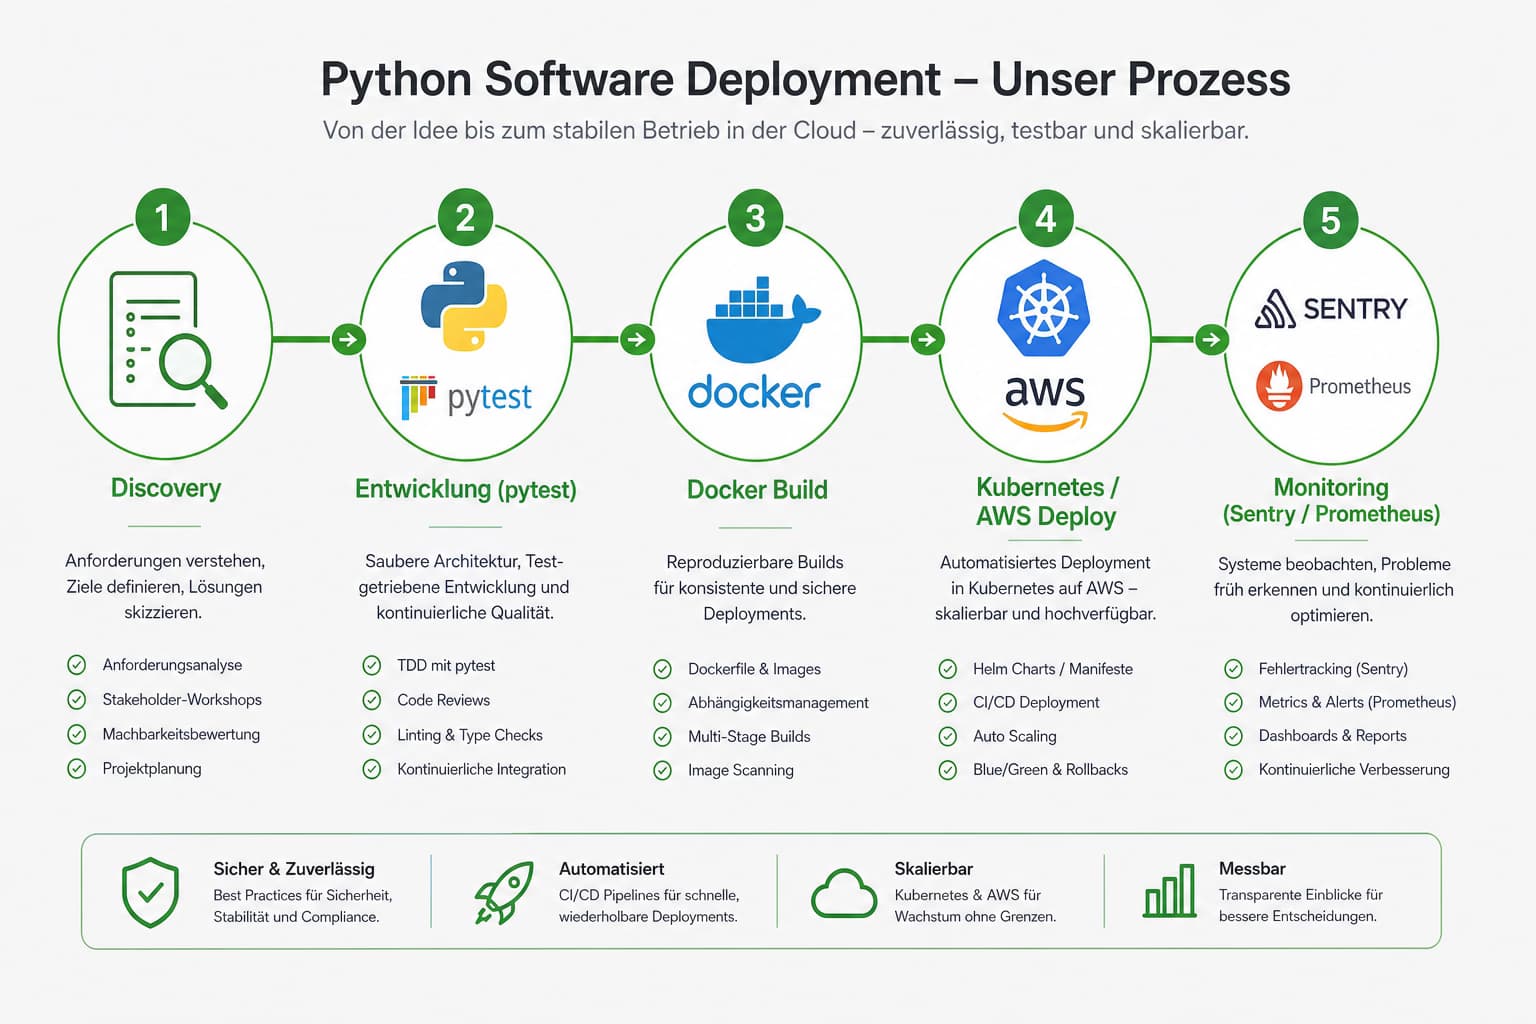
Der Übergang vom Prototyp zum Produktivsystem beginnt mit klaren Abnahmekriterien. Wir prüfen repräsentative Daten, kritische Geschäftswege, Wiederanlauf und Betriebszuständigkeit, bevor Nutzer oder angebundene Systeme auf den neuen Dienst umgestellt werden.
Messwerte für Laufzeit, Fehlerrate und Ressourcenverbrauch werden gegen das vereinbarte Lastprofil erhoben. Konkrete Schwellenwerte und Freigaberegeln vereinbaren wir projektbezogen statt sie pauschal zu garantieren.
- Abnahme: kritische Geschäfts- und Datenpfade reproduzierbar prüfen
- Betrieb: Alarmierung, Wiederanlauf und Eskalationswege festlegen
- Übergabe: Runbook, Zugänge und Verantwortlichkeiten dokumentieren
- Release: Umschaltfenster und Rückfallplan vorab abstimmen
- Nachweis: Ergebnisse und bekannte Einschränkungen im Abnahmebericht festhalten
- Messung: Ausgangswerte und Produktivkennzahlen vergleichbar erfassen
Wir entwickeln Python-Backends, die skalieren und wartbar bleiben. Nach einem kostenlosen Discovery-Gespräch erhalten Sie ein transparentes Festpreisangebot – oder starten Sie direkt im Projekt-Check.
Python-Auftrag und Betriebsübergabe klar festlegen
Django-Anwendungen, FastAPI-Backends, Datenpipelines und KI-Integrationen haben unterschiedliche Betriebsprofile. Deshalb klären wir zuerst Datenquellen, Volumen, Aktualisierungsrhythmus, Schnittstellen und Verantwortlichkeiten. Für ML-spezifische Vorhaben führt die Machine-Learning-Entwicklung tiefer; analytische Fragestellungen gehören zur Datenanalyse.
Übergeben werden Quellcode, reproduzierbare Abhängigkeiten, Tests, Deploymentkonfiguration, Datenflussdokumentation und Runbooks. Eine Python- oder KI-Referenz gilt nur dann als technischer Nachweis, wenn der konkrete Python-Anteil bestätigt ist; allgemeine KI-Projekte stellen wir nicht als Python-Beleg dar. Für LLM-Anbindungen ist die LLM-Integration in Geschäftsanwendungen der passendere Intent.